
글자를 드래그해 선택할 수 있어요
이미 글자 정보가 있는 PDF라면 PDF 워드 변환을 먼저 이용하세요. 사진 속 글자를 다시 인식하는 과정 없이 텍스트를 추출합니다.
사진·스캔 PDF의 한글·영어 글자를 TXT·워드로 꺼내요. 인식한 글자와 숫자는 원본과 비교해 주세요.
또는 아래 버튼으로 선택하세요
PDF · PNG · JPG · JPEG · WEBP · BMP
파일 한 개 · 15MB · PDF 10페이지 · 사진 3,200만 화소
아래 버튼으로 파일을 저장해 주세요.
한국어·영어 인쇄 글자용이에요. 손글씨·흐린 사진·복잡한 표는 오인식될 수 있어요. 숫자와 이름을 확인해 주세요. 표 구조와 원본 서식은 복원하지 않아요.
파일과 변환 결과는 내 브라우저에서 처리해요.
파일 이름과 내용은 서버로 보내지 않아요.
글자가 선명하고 바르게 놓인 사진 또는 PDF를 선택해 주세요. PDF는 최대 10페이지까지 처리해요.
한국어+영어 또는 영어를 선택하고 TXT·워드 중 원하는 결과를 고른 뒤 변환하기를 눌러 주세요.
미리보기와 다운로드한 파일에서 오탈자·숫자를 확인해 주세요. 이미지 품질에 따라 인식 시간이 달라져요.
이미 글자 정보가 있는 PDF라면 PDF 워드 변환을 먼저 이용하세요. 사진 속 글자를 다시 인식하는 과정 없이 텍스트를 추출합니다.
스캔본이나 촬영한 문서처럼 글자 선택이 안 된다면 이 OCR 도구를 이용하세요. 한국어+영어 또는 영어를 고른 뒤 TXT·DOCX로 저장할 수 있어요.
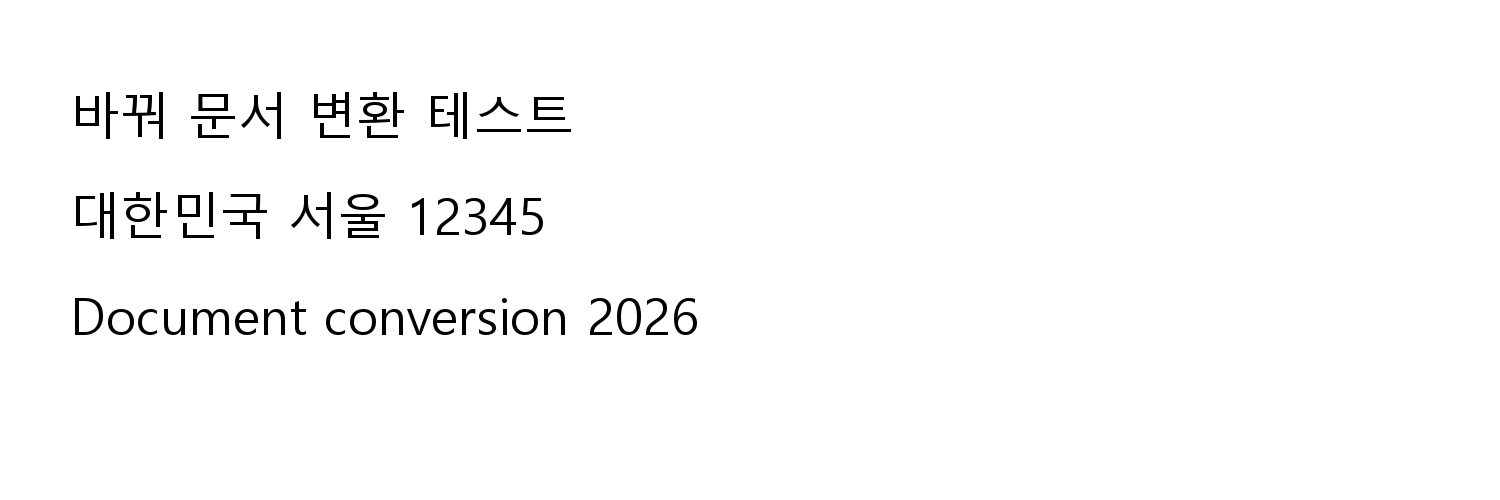
선명한 인쇄 글자로 확인한 한 가지 예시입니다. 손글씨·표·촬영 상태가 다른 문서의 정확도를 뜻하지 않습니다. 인식 결과의 공백과 숫자까지 원본과 비교해 주세요.
PDF 뷰어에서 문장 일부를 드래그해 선택해 보세요. 글자가 선택되면 PDF 워드 변환을 먼저 사용할 수 있습니다. 페이지 전체가 이미지이고 글자를 선택할 수 없으면 OCR이 필요합니다. 문서에 두 종류가 섞여 있을 수도 있습니다.
PNG·JPG·WEBP·BMP 사진과 암호 없는 PDF를 지원해요. 한국어와 영어 인쇄 글자를 인식하며 PDF는 10페이지, 사진은 3,200만 화소까지 선택할 수 있어요.
손글씨·흐린 글자·기울어진 사진은 인식 정확도가 낮아요. 표를 엑셀 셀로 복원하는 기능은 아니며, 글자의 읽는 순서가 달라질 수 있어요.
브라우저에서 실행할 글자 인식 엔진과 언어 데이터를 처음 내려받아요. 인터넷 연결과 기기 성능에 따라 준비 시간이 달라질 수 있어요.
이 도구는 TXT 또는 편집 가능한 DOCX로 저장해요. 원본 모양을 유지하면서 검색·복사할 수 있는 PDF가 필요하다면 검색 가능한 PDF 만들기 도구를 이용하세요.
선택한 파일과 변환 결과는 내 브라우저에서 처리해요. 서버에는 파일 이름이나 내용을 보내지 않고 도구의 이용 완료 횟수만 집계해요. 페이지를 닫기 전에 결과를 다운로드해 주세요.
다른 도움이 필요하다면 이용 안내에서 지원 범위와 오류 해결 방법을 확인해 주세요.